改動後點證明有效:SEO 分割測試的前後對照
截至 2026 年 11 月,判斷一次頁面改動是否真的有效,靠的不是前後兩張流量截圖,而是一組沒有被改動的對照頁面、同一段日期,以及測試開始前就寫定的判定規則。一份完整的 seo 計劃 若要在會議室裡站得住,量度方式就要跟改動方式對齊:同一批頁面、同一組查詢、同一段時間,才有可比的前後對照。
Search Engine Journal 於 2026 年 11 月 9 日刊出的文章提出一個很直接的挑戰:客戶問「如果這次用 A/B 分割測試做,我們要量哪個指標、真正想達成咩?」文章指出,多年來的標準答案是前後對照圖,「三月改標題、四月點擊上升,大家點頭」,但管理層下一句通常是「你點知唔係 Google 自己變?」核心更新、季節性與 AI 搜尋功能都會在你沒有改動任何東西時令流量移動。
本文把這個問題拆成可執行的部分:點解前後對照證明不了成效、對照組應該點揀、需要哪些數字、報告要點寫,以及香港中小企在樣本不足時可以怎樣做。
為何「流量上升」不算證據
自然流量的變動來源太多,而且幾樣一齊發生。季節與需求會變,核心更新會來,競爭對手會改自己的網站甚至改壞它,品牌活動與付費媒體會帶動品牌搜尋,追蹤本身也會出問題,例如 GA4 標籤或同意橫幅。
搜尋結果頁本身也是變數。AI Overviews 與 AI Mode 可以在排名完全沒有變動的情況下改變點擊率。問法要換成:如果沒有這次改動,流量會是幾多?這個估計叫反事實(counterfactual),所有可信的 SEO 測試都是在建立它。
這一點與 Topkee 在交付記錄上的立場一致:成效報告要求「避免將同期變化直接歸因於單一修改」,同期變化本身不構成因果證明。
一次站得住的結果,背後有四樣東西
Search Engine Journal 歸納出在財務團隊面前站得住的結果通常有四項支撐:
- 公平的比較:同期、相似但沒有被改動的頁面。
- 一個區間,而不是一個單一數字。「點擊上升一成四」會引來爭論,換成「模型估計升幅介乎百分之八至十九」,對方就無從反駁。
- 商業結果:點擊與排名是先行指標,測試頁面的收入或查詢才是財務部關心的。
- 測試開始前就寫定的判定規則。這是最多團隊跳過的一項。
第四項正是那位客戶的問題所在:如果看過數據之後才決定用哪個指標、幾多才算贏,你總會找到方法把它叫做贏。
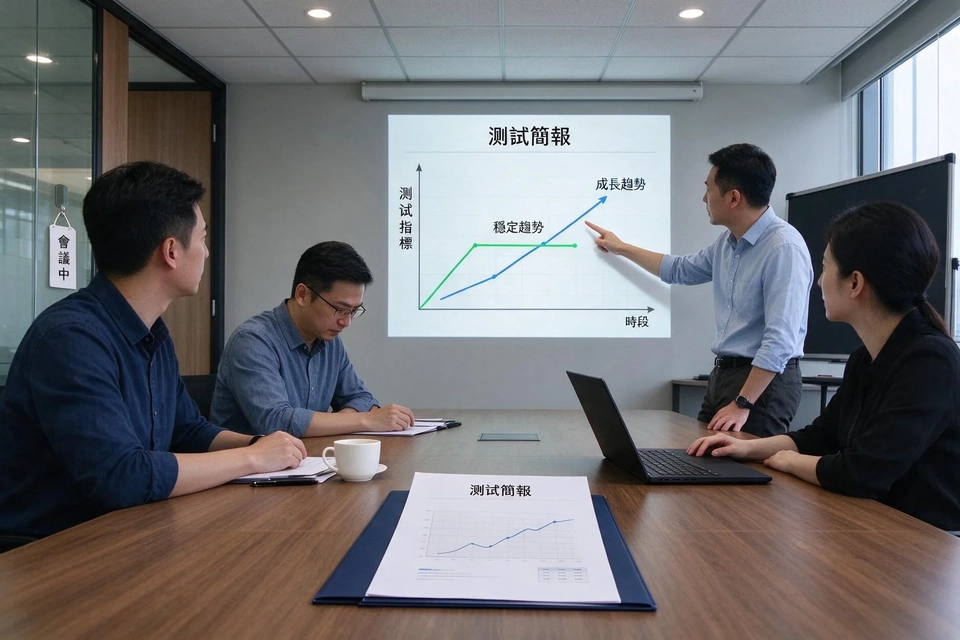
先寫一頁測試簡報,再動手
文章建議的補救方法很短:上線前寫好、並分享一份一頁簡報。它包含:假設(改甚麼、為何認為有幫助)、主要指標(多數頁面改動用非品牌自然點擊)、護欄(不能跌破的指標,例如轉化率)、值得行動的最小升幅、分析日期(以完整週為單位,令每星期各日平均出現),以及判定規則(甚麼結果代表全面推行、回退或記錄為未能判定)。
一頁簡報把最後的對話由「我信唔信你」變成「我哋有無通過當初講好的測試」。對任何一份 seo 計劃 而言,這頁紙就是測試的合約底稿。
SEO 分割測試不是把訪客一分為二
很多人把 SEO 分割測試與 CRO 測試混淆。CRO 測試把訪客分到兩個版本的頁面;SEO 測試不能這樣做,因為 Google 同一時間只會為每個網址排名一個版本,而且向 Googlebot 展示與用戶不同的頁面屬於 cloaking,違反 Google 的網站測試指引。
所以 SEO 分割測試分的是頁面,不是訪客:取同一範本的一組頁面(產品、分類或地區頁),分成兩組,variation 組套用改動,control 組完全不動。文章指出成敗取决於幾件事:
- 配對好的分組:兩組在測試開始前行為要相若;爭奪同一批查詢的頁面應留在同一單位,否則得勝的 variation 只是從 control 搶走點擊。
- 同期進行:兩組在同一段日期跑,令核心更新或假期高峰同時落在兩邊。
- 預測:用 control 組建立 variation 組在沒有改動下的走勢,預測與實際之間的差距就是結果。
- 上線前檢查:在過去挑幾個假裝的上線日期,用之前數據訓練模型,看它能否準確預測之後同等長度的週數;如果它在沒有事情發生的期間也「找到」效果,就不能告訴你這次改動做了甚麼。
Google 開源的 CausalImpact 套件是建立這個預測最為人熟悉的模型。其文件說明,它給定一條回應時間序列(例如點擊)與一組對照時間序列(例如未受影響市場的點擊),建立貝葉斯結構時間序列模型去預測反事實。
分桶:把相似頁面分成兩邊
SearchPilot 的文章解釋,分桶(bucketing)就是為測試找出 control 與 variant 兩組頁面,而這一步往往仍然全人手處理,拖慢進度、消耗資源。其智能分桶會在上線測試前自動把頁面分成兩組,大致平分(約各一半),並考慮平均流量水平、流量變異與季節性,令兩組在統計上相近。
人手或隨機分桶的問題在於:同一網站分區內少數頁面會佔去大部分流量(冪律),同一分區的頁面之間又高度相關,例如夏季的目的地頁在夏季流量相近。若不再平均分配這些頁面,測試就會樣本不足,結果變成大量無結論與假陽性。
改動本身很貴時:用相似頁做對照
有一種情況令分割測試很難做:改動本身需要大量開發資源。SearchPilot 舉例,若要為每個 variant 頁面加入獨有的自訂模組,而桶內有 1,000 個頁面,所需開發資源龐大;即使有能力,也要先肯定回報值得。等待資源建好模組期間,被分桶的頁面還可能「過時」,統計相似性自然改變。
其 lookalike 分桶算法因此改為:你先給一份較短、預先定好的改動頁面名單,測試開始時算法即時生成最新的相似 control 頁面,令小規模測試仍能得到與常規分桶相近的準確度。文章指出同一做法也適用於人手撰寫的獨有內容:先在小組 control 與 variant 頁面上測試,再判斷是否值得為整個分區重寫。
唔同網站,揀唔同方法
Search Engine Journal 按網站規模整理出四種做法,各自的比較來源與風險不同:
| 方法 | 比較從何而來 | 適合 | 要留意 |
|---|---|---|---|
| 頁面分割 | 同一範本、同期未被改動的頁面 | 大型範本化網站,如電商、市集、出版商、多門店品牌 | 需要規模,且能只向部分頁面推行改動 |
| 地區分割 | 沒有推行改動的市場或地點 | 國際網站、特許經營、本地 SEO | 市場鮮有完全一致行為,須按歷史走勢配對 |
| 模型基線 | 改動不可能觸及的數據,如可比市場或外部需求數據 | 沒有乾淨對照的全站改動,如導覽更新 | 若比較數據也被改動影響,結論很弱 |
| 前後對照 | 同一批頁面的過去表現 | 小網站與單一頁面 | 無法把改動與季節、更新分開 |
若只能做前後對照,仍可令它更有說服力:保留一組刻意不改動的相似頁面作 holdout;用 Search Console 的品牌查詢篩選把品牌需求分開(Google 提醒部分查詢可能被誤判,用品牌詞的正則篩選作交叉核對);並在改動上線當日在 Search Console 加入自訂標註。
工具選擇跟隨同一分界:企業平台如 SearchPilot 與 seoClarity 的測試工具負責部署與建模,SEOTesting.com 面向較小網站做基於 Search Console 的測試,CausalImpact 在有內部數據支援時免費。若你的 CMS 本身可以只改同一範本的子集頁面,頭幾次測試未必需要平台,而能只改子集正是多數 seo顧問 建議先做小範圍的原因。
如何用對照組與事前寫定的判定規則,證明一次頁面改動真的帶來成效
這一節是整套方法的落點:把「點樣判定」寫在測試之前,令結論可以被推翻,也可以被別人重跑。
- 固定比較單位:同一範本的一組頁面,爭奪同一批查詢的頁面歸為同一單位,再按流量水平與類別配對、隨機分派到兩組。
- 固定觀察窗:兩組同期跑,分析日期取完整週,令每星期的每一日都被同等代表。
- 固定主要指標與護欄:主要指標、不能跌破的護欄、值得行動的最小升幅,全部在上線前寫入簡報。
- 固定判定規則:先講清楚甚麼結果代表推行、回退、或記錄為未能判定;不要在看到數據之後才定義成功。
- 先做上線前檢查:用過去的假裝上線日驗證模型在「無事發生」期間不會虛報效果,否則模型不足以判斷今次改動。
這五步的共同點是:判定規則先於數據存在。缺少第 4 步,任何結果都可以在事後被解釋成勝利;有了它,測試就由「靠信任」變成「靠條件」,這也正是 seo排名 報告最難被追問的地方。
財務部看得懂的幾個數字
一個好的分割測試報告只需要幾個數字:
- 相對預測的升幅:variation 組實際表現與模型預期之間的差距,是標題數字,但絕不能單獨出現。
- 區間:模型認為合理的效果範圍。若區間包含零,結果就不顯示正面效果。
- 正面效果的概率:最容易讓非技術同事明白的數字,但要確認工具在報甚麼;CausalImpact 的「因果效果概率」不說明方向,一個很有信心的虧損可以與勝利得到同樣高的分數。九成的正面效果概率,仍留下一成機會是改動沒有效果或令情況變差。
- 測試頁面的收入或轉化:把 SEO 結果變成商業個案的數字。收入比點擊嘈雜,量小時只宜作方向性參考。
- 排名:可以解釋點擊為何移動,但要與對照組比較,本身從不是證據。
2026 年的新數字:AI 可見度
Search Console 的生成式 AI 成效報告於 2026 年 6 月 3 日公布,Google 在公告中說明,這些見解在 2026 年 8 月 31 日已向全球所有網站推出。報告顯示你的網址在 AI Overviews 與 AI Mode 等生成式 AI 功能中的曝光次數,可按頁面、國家、裝置與日期查看。
這意味你可以用與點擊相同的方式,比較 variation 與 control 兩組的 AI 功能曝光。若改動令點擊上升但 AI 可見度下降,或反過來,都值得在全面推行前查清。目前報告沒有點擊數據,只宜作輔助訊號。
一個完整的例子:由簡報到推行
文章用一個完整的測試形狀示範流程,並明確標示當中數字屬示範性質,不是任何客戶的實際結果。做法分四步:
- 改動:為產品頁換上新的標題與 meta description 範本,先講消費者搜尋的內容而不是品牌名。
- 簡報:主要指標定為非品牌自然點擊;轉化率設為護欄,不得相對 control 跌破約定上限;同時寫明值得行動的最小升幅與六週的分析日期;範本只在可信區間完全高於零、中心估計高於該最小升幅、護欄守得住時才推行。
- 分組:取一批產品頁,把爭奪同一批查詢的頁面歸在一起,再按流量水平與類別配對、隨機分派成兩組,並先通過上線前檢查。
- 結果:區間在測試中段首次完全高於零,但測試仍按約定跑到分析日期,效果持續;測試頁面來自自然流量的收入升幅區間遠闊於點擊結果,故只作方向性報告;目標詞平均排名上升,而 control 保持平穩,這解釋了額外點擊從何而來。最後範本推行到其餘產品頁,並轉為持續監察,因為已沒有對照組可證明。
文章亦提醒,多數測試不會這樣整齊。SearchPilot 曾把一批具代表性的舊測試用最新模型重跑,除了模型選型之外,這批結果說明即使有專用模型,相當比例的測試仍然沒有在約定的信心水平下顯著勝出。多數改動並非完全無效,只是在全站推行之前值得知道。
讓持份者相信你的報告方式
先講決定,再講方法。多數持份者想知道三件事:你建議甚麼、你有幾肯定、值幾多。一頁報告通常包含:建議(推行、回退或記錄為未能判定)、一句話結果、值幾多(測試頁面的收入或查詢,加上寫明假設的推行預測)、你點測試(頁面、分組、日期、方法,以及測試期間發生過的事如核心更新)、下一步。
做推行預測時,由區間較保守的一端開始,寫明其餘頁面與已測試頁面的差異,並稱之為情境而非結果。若全站推行勝過保守數字,你建立信任;若低於樂觀數字,你就會失去它。
還有一點:報告輸出的測試。只記錄勝仗的測試日誌看起來就是挑選過的,因為事實如此。分享負面與未能判定的結果,才是令勝利可信的原因。
會靜靜令測試失效的錯誤
第一,看到好結果就停。可以每日監察以找出推行問題,但判定應在約定的分析日期做,除非你的平台使用為持續監察而設的方法。第一次過線就下結論,會大幅提高推出假陽性的機會。
第二,沒有確認 Google 看到改動。部分工具以 JavaScript 套用改動,應以網址檢查工具確認改動出現在已轉譯的 HTML,並核對 variation 頁面在上線後曾被重新檢索。標題測試尤其要留意:Google 在認為有更好選擇時會改寫標題連結,你測試的標題不一定就是搜尋者看到的。
Topkee 的做法:把改動單位與量度單位對齊
Topkee 的 SEO 服務以「關鍵字簇+目標頁面」為工作單位,交付包括診斷、頁面優化、執行記錄與排名報告;收費按網站基礎、競爭差距與工作量訂製,搜尋排名不作無條件保證。適用對象是已有可維護網站、服務範圍清楚、能提供案例與資料授權的香港專業服務、B2B 供應商及中小企業。其意義正在於:改動與量度的單位一致,同一頁面承接的關鍵字簇可以前後對照,不會出現「改了 A 頁、量了全站」的落差。
在驗收條款上,Topkee 把「怎麼算達標」拆成指標、樣本與判定規則:訂單先列明搜尋引擎、地區、語言、設備、詞表、目標域名、採樣時間及自然網頁結果的計數方式;驗收可約定連續一段固定日數內,至少約定的高比例有效採樣進入指定排名區間、有效採樣覆蓋率達到約定水平;資料不足時標記「未能判定」,不以零或缺失值代替成功,交付完成與成效改善分開驗收。驗收條款寫在合約,測試簡報寫在測試之前,兩者要固定的是同一批條件。
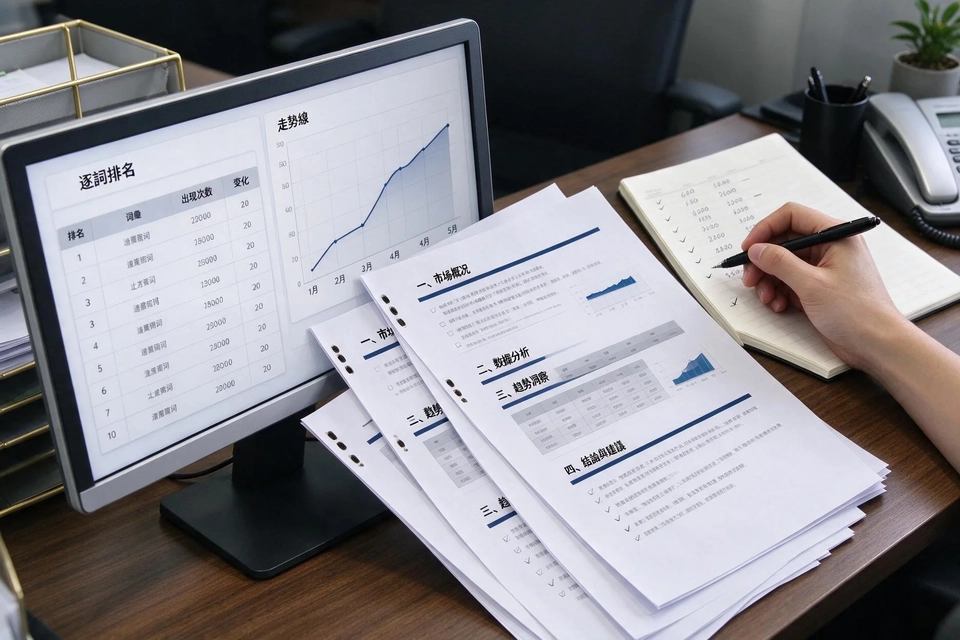
報告層面,Topkee 的交付記錄分為工作交付、搜尋表現、訪問與機會、下一步四層,並明言避免將同期變化直接歸因於單一修改。其 SEO 報告可自行設定日、週或月週期,列出逐詞排名變化、頁面表現、索引狀態與 KPI。工具頁提供的模擬月度報告樣例逐詞追蹤多個關鍵詞,可見度詞數由一個增至四個,其餘多數改善,少數持平;該樣例註明為獨立製作的模擬截圖,不是後台畫面或真實客戶成果,用以示範核對逐詞變化與工作狀態,本身不以同期變化證明因果。
對香港中小企來說,這些數字與規則的價值不在於好看,而在於可被追問。當你用 seo顧問 的報告向老闆或財務交代時,問題會由「點解你話有效」變成「我哋有無通過當初講好的條件」。
樣本不足時的替代做法
不是每個網站都能做標準分割測試。文章引述 SearchPilot 的經驗法則:被測試的分區每日需有一定數量的自然訪問,低於此數,測試往往拖長或永遠得不到清楚答案。下面用表格對照本文的建議與標準做法在不同網站規模下的差別:
| 網站情況 | 可用的比較 | 應寫進報告的限制 |
|---|---|---|
| 大型範本化網站,分區流量充足 | 同範本、同期未改動頁面的頁面分割 | 仍須記錄測試期間的核心更新與季節因素 |
| 多市場或連鎖品牌 | 未推行改動的地區作對照 | 市場行為難以完全一致,須按歷史走勢配對 |
| 全站改動、無乾淨對照 | 模型基線(可比市場或外部需求數據) | 比較數據若受改動影響,結論很弱 |
| 小網站與單一頁面 | 前後對照加 holdout 頁面 | 只能分開季節與更新的影響,不能當隨機實驗 |
多數情況下小網站不能測試,而是要在設計上誠實。較可行的是:保留一組 holdout 頁面、用 Search Console 的品牌篩選與自訂標註、把觀察窗拉到完整週、並在報告中明言這是前後對照而非隨機實驗。CausalImpact 一類模型在沒有隨機實驗時仍可建立反事實,但它的結論依赖較強的假設:對照時間序列本身未受干預影響,且干預前建立的協變量關係在干預後保持穩定。假設不成立,效果就會被高估或低估,甚至把「沒有發生」判成「有發生」。
對本地專業服務與 B2B 供應商而言,可行的做法是先固定關鍵字簇,再逐頁記錄改動與日期,令半年後回頭仍有可比對的條件。這也是 seo 計劃 一開始就該寫清楚的事。
下一步:把下次改動寫成可驗證的測試
如果手上正有一批頁面準備改動,可以先用本文的五步做一次小型測試簡報:定好比較單位、護欄、最小升幅與判定規則,再決定要不要全面推行。想知道怎樣在樣本有限的情況下仍交出可對照的 seo排名 記錄,可以先看站內的 SEO 優化服務頁,了解量度單位與交付記錄的劃分;內容層面的改動如何影響排名與信任,則可參考 SEO 內容寫作 的說明。
常見問題
SEO 分割測試同 CRO A/B 測試有咩分別?
CRO 測試把訪客分到兩個版本的頁面;SEO 分割測試分的是頁面。Google 同一時間只為每個網址排名一個版本,向 Googlebot 展示不同頁面屬 cloaking,違反 Google 的網站測試指引。
網站流量唔夠,仲可唔可以做分割測試?
可以先做較弱的設計:保留 holdout 頁面、用模型基線建立反事實、把觀察窗拉到完整週,並在報告中明言這是前後對照。標準分割測試需要一定規模,分區每日的自然訪問量不足時,測試往往拖長或得不到清楚答案。
測試幾時可以停?
在約定的分析日期停,除非平台使用為持續監察而設的方法。看到第一次過線就停,會提高推出假陽性的機會。
判斷規則要幾時寫?
上線之前。指標、護欄、最小值得行動升幅與勝利條件,全部寫入一頁簡報並分享。看過數據才定義成功,等於永遠可以找到方法把它叫做贏。
AI Overviews 的曝光要唔要計入測試?
可以,但要視為輔助訊號。Search Console 的生成式 AI 成效報告自 2026 年 8 月 31 日起向全球所有網站推出,可比較兩組頁面的 AI 功能曝光,但目前沒有點擊數據。
Sources
- SEO Split Testing In 2027: How To Prove A Change Actually Worked, Search Engine Journal, 2026-11-09. https://www.searchenginejournal.com/seo-split-testing-prove-change-worked/594529/
- Search Generative AI performance reports in Search Console, Google Search Central Blog, 2026-06-03. https://developers.google.com/search/blog/2026/06/gen-ai-performance-reports
- How smart bucketing can strengthen your SEO testing approach and deliver accurate traffic data, SearchPilot. https://www.searchpilot.com/resources/blog/how-smart-bucketing-can-strengthen-your-seo-testing-approach-and-deliver-accurate-traffic-data
- CausalImpact: An R package for causal inference using Bayesian structural time-series models, Google. https://google.github.io/CausalImpact/CausalImpact.html