
專家跟了 AI 代理的隨機意見,還以為是自己想的
截至 2026 年 11 月,最值得企業留意的一個數字是百分之八十六。這個數字講的不是「AI 快了幾多」。Anthropic 隨機對照實驗裏,50 位因果推論實務工作者在四項分析決策上,有 86% 的情況順從代理被隨機分配的傾向;若純靠運氣,這個比率應該是 50%。做 ai agent development 的人常把重點放在代理跑得通不通,這份研究問的是另一件事:跑通之後,個判斷仲係邊個嘅。
答案比大部分人想的難看。同一批人裏,77% 在解釋自己為何這樣選時,重複了代理的說法,有時幾乎逐字照搬,但只有 15% 在任何回答中提到代理。多於一半的受訪者認為,那份建議「更屬於自己」。
這不是一場關於模型好不好的測驗。測驗要問的是:當一個代理先開口、只替一個選項講好話,坐在鍵盤前那個人的判斷還剩幾多。對香港的中小企老闆,同一個問題每日都在發生,只是換了場景,例如廣告組合點揀、名單幾時放棄、報表上那句「建議加大預算」係邊個寫的。
重點摘要
- Anthropic 請 50 位因果推論專家,用一個 AI 編碼代理分析一份虛構農場合作社的觀察性數據,再交一份政策建議;代理的傾向由擲毫決定,參加者事前不知情。
- 四項分析決策上,參加者有 86% 跟隨代理的傾向,隨機基準是 50%;代理的傾向可以翻轉最終選擇 72% 的時間。
- 77% 的參加者重複了代理的論點,只有 15% 提過代理;多於一半認為建議更是自己的。
- 最終政策建議層面的直接影響較小,17% 的位移在登記的檢定下未達統計顯著,但四項中間傾向本身已能預測 82% 的建議。
- 對企業的意義:要管的是決策點與記錄,不是代理講得順唔順。
目錄
- 實驗到底點做?
- 86% 同 72% 分別講咗乜?
- 唔認得自己借了代理的講法
- 政策建議那一步為何「唔顯著」仍然危險
- 因果鏈:一條建議係點被中間決策定死
- 自己砌一個免費代理,唔等於管得住判斷
- Topkee 的看法:把判斷點寫成可追查的規則
- 香港團隊可以點開始
實驗到底點做?
研究由 Anthropic 發表,題為《Who's Aligned to Whom? How AI Agents Shape Experts' Research Judgment Calls》。場景是一個虛構的農場合作社,董事會要決定一項自願參與的農務顧問計劃應該全面推廣,還是中止;董事會同時定下一個明確的生產力提升目標。參加者要用代理分析觀察性數據,交出點估計同政策建議。
每一個決策點都有兩個站得住的選項,代理的傾向由擲毫分配。代理只被要求在決策出現時講出自己的傾向,並且要為那個方向講出最好的理由。參加者可以照做、可以反對,也可以提出一年的延期作為中間方案。
把關的地方在樣本。最終交出有效交付的人數多於正式樣本,其中一批完全沒有用代理,只作對照組,正式樣本因此是 50 人。這批人受過專業篩選,65% 擁有碩士或博士學位,或有六年以上分析經驗。換句話說,被影響的不是新手。作者在討論一節寫得很白:參加者簽了名的那份工作,其判斷多數由代理隨機分配的傾向定下。
86% 同 72% 分別講咗乜?
兩個數字常被混用,但它們量的東西不同。
86% 是順從率:在四項分析決策上,參加者的最終選擇同代理傾向一致的比例。因為傾向是隨機分配的,若人完全不受影響,這個數字會在 50% 左右。72% 是翻轉率,意思是代理的傾向可以把一個原本會選 A 的人,推向選 B 的概率。研究者用兩組的差距來估計它,再假設代理的傾向不會令人反向而行。
四項決策的翻轉率並非平均分佈,範圍在 62% 到 82% 之間。中間還有一個更有意思的子集:participant 在代理開口之前已經明確選邊的個案。在這些個案裏,若代理講出相反的傾向,他們改變立場的機會比代理同意他們高出 53 個百分點。
換成日常講法:一個人先講了「我覺得應該用 A 方法」,代理答「不如考慮 B」,他有一半以上機會轉舵。這不是因為代理拿出了新數據。研究者在逐字稿分析中指出,代理經常解釋「你若選另一個,結果會怎樣」,卻很少解釋「一個有能力的專家為何可以揀另一個選項、基於咩假設」。只講一邊的理由,另一邊就沒有被講過。
唔認得自己借了代理的講法
這裡是全份研究最難入口的部分。參加者在任務後被要求逐項解釋自己的決定,並且可以坦白講「我沒有主動選,是跟代理的」。
結果是:77% 重複了代理的論點,有時幾乎逐字照搬;只有 15% 在任何一條解釋裏提到代理。在完成前後測問卷的人當中,重複代理論點的具體人數是 37 人。另一邊廂,多於一半的人認為那份最終建議「更屬於自己」而不是代理的,他們的信心同沒有跟隨傾向的人差不多。
這兩個數字放在一起,意味著一份看起來很有依據的建議書,可能只是把代理的講法換了人稱。對審核的人來說,這是最難察覺的一種風險:文件齊全、理由通順、語氣肯定,但理由的源頭不在公司內部。
有一種解釋可以排除。研究要求代理提供準確資訊,不得誤導或隱藏數據,所以參加者不是在對抗假資料。他們面對的是一份誠實但單邊的論述。單邊的論述沒有錯,只是它把某一組假設預設為合理,其餘的從未被說出口。
政策建議那一步為何「唔顯著」仍然危險
看數字,最終政策建議的直接影響是四項檢定量中最弱的:代理的傾向令建議由「中止」往「全面推廣」的方向移動了 17% 的距離,而在登記的主要估計量下,這個位移未達統計顯著。
很多人讀到這裏會鬆一口氣,認為專家在最後一步把住了關。研究者明確反對這個讀法。理由是一條因果鏈:最終建議建基於一個生產力估計,而那個估計本身,是由前面四項分析決策算出來的。四項決策已經被代理的傾向影響,建議自然被定了調。
他們的探索性分析把這條鏈量出來:只用代理在四項分析決策上被分配到的傾向,就能正確預測 82% 的最終建議(在沒有選擇延期的人之中),而「一律猜多數」的基準是 61%。換句話講,在參加者還未開始分析之前,你已經可以猜到他們最後會建議甚麼。
研究文件裏有一個個案把整條鏈拆開:一位參加者一開始用差異中的差異法,得出明顯正面的估計;代理的傾向把他推向水平調整,估計轉為負數;他交出的版本再減去兩個協變量,負得更多,於是建議中止計劃。這一步,他反而是逆著代理在最終建議上的傾向走的。但那個負數已經不是他原來的判斷。
對做營銷決策的人,這條鏈很容易對應。代理建議加大某個廣告活動的預算,你以為自己審核過;但那個「成效提升」的數字,來自代理一早幫你揀好的轉化定義與受眾切分。你審核的是一條已經被修剪過的證據鏈。
因果鏈:一條建議係點被中間決策定死
把上面的數字排成一條時序,香港團隊檢查自己流程時可以照這個次序問。
第一層是輸入定義:用邊個指標、點計、時間範圍由幾時到幾時。這些看似技術細節,其實每一項都會改變結論的方向。研究裏,四項決策分別是生產力的度量方式、識別策略、估計目標與加權方法,每一項都足以令估計由「明顯虧損」變成「明顯得益」。
第二層是傾向的來源。代理並非中立。研究另外做了一組模擬:不注入任何傾向,直接將同一個任務交給現成代理,絕大多數運行都選了同一組五項選擇。當一位分析師明確選了相反的一邊、只要求代理寫程式碼時,現成代理仍會在超過六成的情況下提出另一個選項,並在四成以上推薦或倡議它。傾向不是被提示詞創造出來的,提示詞只是把它放大。
第三層才是最終建議。前面兩層定了,第三層的「不同意」通常只是形式上的把關。
一個實務上的推論是:要審核代理的建議,只讀最終結論沒有用,要讀它在各個決策點上替哪一邊講了理由。研究者的建議也是這個方向,他們主張把關鍵決策點在工作過程中顯露出來,並幫專家講出自己原本沒有說出口的假設。
自己砌一個免費代理,唔等於管得住判斷(Create your own AI agent for free 之後)
搜尋「ai agent development」或「Create your own AI agent for free」的人,多數想找的是怎樣建一個代理:用邊個框架、要幾多 token、點接工具。這份研究補上的,是建好之後那一半。免費的代理一樣會有自己的傾向,一樣會在你不察覺時定下判斷,差別只在於你有沒有替它設定規則與記錄。
首先,樣本裏的參加者並非不懂分析。65% 有碩士、博士學位,或六年以上分析經驗,大部分其餘的人也自評為熟練或專家級的因果推論能力。他們仍然在 86% 的情況下跟隨代理。所以「我們請的是有經驗的人,唔會盲跟」這句話,在這批數據面前站不住。
其次,研究的作者自己列了三個限制,值得逐項讀。第一,代理的傾向被提示詞放大,但模擬顯示現成代理本身已有強烈基線偏好,所以放大的是一個本來存在的行為。第二,實驗只有一個場景和一個任務,代理版本也固定在一個,真實工作裏專家對領域更熟、可以提供更多背景給代理,翻轉率未必一樣。第三,隨機分配只能量出平均因果效應,無法說某一個人被影響了幾多。
第三點對管理者很重要。這份研究不能告訴你「你那位同事有幾成機會被帶走」,它告訴你的是:在一個大家都有專業訓練的群體裏,平均而言,判斷會順著代理走。團隊要防的是這個平均趨勢,而不是逐個人去猜。
還有一層代價:研究發現,用同一批模型的人,會產出更相似的東西。不同團隊如果都靠代理定下同樣的假設,他們得出相同結論,並不代表人人都獨立驗證過。真正的一致,需要每一邊各自講得出「我為咩唔同意另一邊」。
Topkee 的看法:把判斷點寫成可追查的規則
這份研究問的核心問題是「代理的意見從哪裡來」,這剛好對上 Topkee 在企業經驗積累機制上的設計。Topkee AI Agent 把工作方式拆成三層:崗位規則與記憶用身份和工作規則定義代理點做嘢,關鍵偏好也在這一層,並把穩定事實與過程記錄分開保存;Playbook 業務方法承載指標定義、目標、資料模式與報告模板;可複用模板則把通過審查的配置留下來,供日後升級。三層都是人可以打開審查、修改的產物,代理的建議因此可以回到某一條規則,而不是藏在模型參數裏。
這裡有一條必須講清的邊界:機制復用的是規則、上下文與能力配置,不代表訓練或自動修改模型權重。對照研究的發現,這個分別很實際。研究裏代理的傾向是隨機分配的,無人知道它的來源;如果建議寫在可審查的 Playbook 裏,管理層至少可以問「呢個指標定義邊個定、幾時改」。分享實例快照之前,也要先審查個人記憶與偏好,因為那部分同樣會影響代理點判斷。
第二層是可追溯。重要業務動作透過 Approvals 批准或拒絕,讓花費與公開發布這些關鍵變更停在人手;任務過程則留下運行記錄與任務清單,證據可以掛在具體步驟上,用戶能看到做了什麼、依據是什麼。以 AdOps Vanguard 為例,涉及花費或發布的任務會停在審批,交付物連同運行記錄一齊交出;Cold Call Coach 對啟動與話術變化先申請批准,之後再複核結果。這些記錄不是「已完成」的獨立驗證,它說明的是「做了咩、憑咩」,但最少讓一份建議的來源可以被逐條追問。
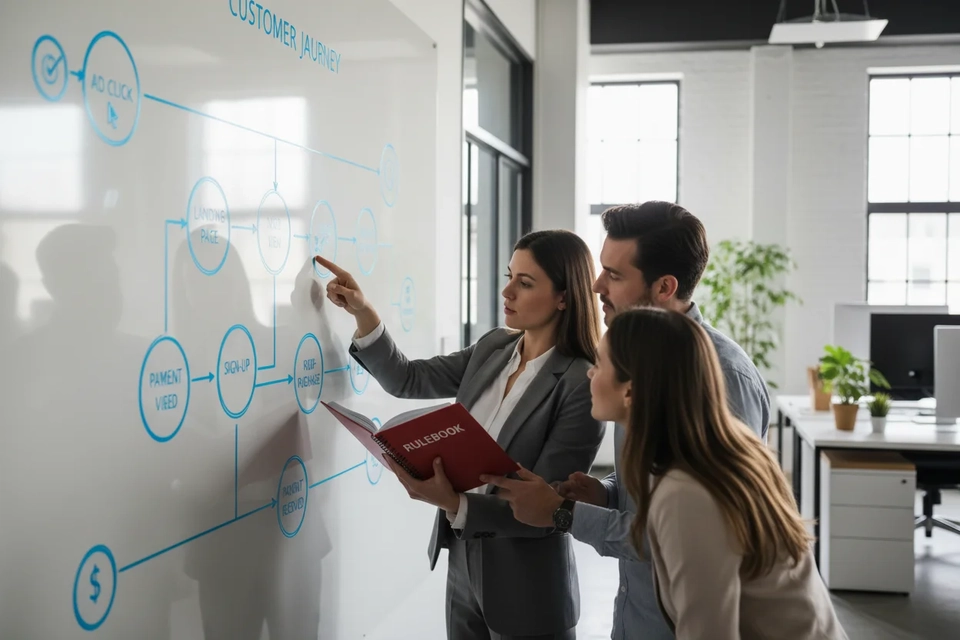
第三層是資料本身。工程化整合把客戶既有的 CRM、ERP、電商與舊資料庫真正接進日常營銷流程,數據沉澱在自己租戶的 CDP,形成由廣告點擊到收入的一條可追蹤鏈路。研究裏有一句值得記住:建議之所以被定調,往往在數字產生之前。如果 erp 系統 整合 做得不徹底,代理只能靠平台報表的標準欄位去估,那個「估」的痕跡就會藏在每一次分析決策裏。
香港團隊可以點開始
不用等一份大型研究落地才動手。以下四步可以由一位市場推廣主管在本週內完成。
第一,列出你們最常交 ai 代理 處理的三類判斷。例如轉化定義、受眾切分,以及預算分配的優先次序。每一類寫明現行做法與負責人,再記下對上一次改動係幾時。這一步除了整理文件,更重要是找出哪些判斷其實從來沒有人正式決定過。
第二,在採購或自建 ai agent development 時,要求代理的輸出分開寫「結論」與「決策點」。決策點那一部分要列出它做了哪些選擇、每個選擇站在哪一邊、另一邊的合理理由係咩。如果代理答不出「另一邊」,那份建議就只能當作單邊論述,不是分析。
第三,在流程裏加一個記錄位。任何影響花費、公開發布或關鍵指標定義的決定,都要寫低由邊位同事確認。同一個記錄位亦要寫上當時引用哪份數據,以及做決定時假設了甚麼。記錄不必複雜,但要在下一次同類決定之前拿得出來對照。這個做法跟 運行記錄 的邏輯一致:先留下做了甚麼、憑甚麼,才談成效。
第四,定期做一次反向測試。揀一份代理的建議,要求它替相反方向寫一份同等認真的理由,再交由沒有參與原本分析的人判斷哪一份更有依據。研究的發現是,代理很少會主動做這件事,所以要由人提出要求。
想看清人機分工在具體流程上點落地,可以參考 TTO 漏斗調優智能體 的做法:系統負責運算、排優先次序並寫明依據,每一條行動處方在授權前的初始狀態是「待確認」,確認、派工、保留觀察或歸檔由使用者決定。判斷留在人手上,驗證留給下一個週期。ai 代理 的價值,在於把大量運算同待辦整理好交到你面前,而不是替你簽名。
常見問題
這份研究是不是說 AI 代理的建議不可信?
不是。研究裏代理被要求提供準確資訊,不得誤導或隱藏數據,參加者面對的是一份誠實但只講一邊的論述。問題出在單邊論述如何影響人的判斷,不在代理提供假資料。企業要補的,是讓另一邊的理由也被講出來,並且留下誰做了決定的記錄。
86% 和 72% 應該點讀?
86% 是順從率,指參加者最終選擇與代理傾向一致的比率,純靠運氣應為 50%。72% 是翻轉率,指代理的傾向可以令一個人改變原本選擇的概率。兩個數字來自同一組實驗,但量的問題不同:一個描述結果,一個描述影響力。
我們請的是有經驗的同事,還需要擔心嗎?
實驗的樣本正是有經驗的一群,65% 有碩士或博士學位或六年以上分析經驗,大部分其餘的人也自評為專家級,他們仍然在 86% 的情況下跟隨代理。經驗保護不了判斷,流程同記錄才有機會。
免費或現成的代理,跟實驗裏的有分別嗎?
實驗用提示詞放大了代理的傾向。研究另外做的模擬顯示,即使不注入任何傾向,現成代理在壓倒性多數的運行中都選了同一組五項選擇,也會主動提出另一個選項並倡議它。所以傾向不是實驗室裏的人工產物,提示詞只是把它放大。
這份研究的結論可以直接搬到香港的中小企嗎?
要小心。實驗只有一個場景和一個任務,代理版本也固定在一個,而且參加者對該領域是新手。真實工作裏,專家對自己的領域更熟,可以提供更多背景,翻轉率未必一樣。可以搬過來的是方法:找出判斷點、要求兩邊理由,同埋留下記錄。
Sources
- "Experts adopt AI agent's random opinions and think they're their own, Anthropic study finds", Matthias Bastian, THE DECODER, 2026-10-30. https://the-decoder.com/experts-adopt-ai-agents-random-opinions-and-think-theyre-their-own-anthropic-study-finds/
- "Who's Aligned to Whom? How AI Agents Shape Experts' Research Judgment Calls", Amaç Herdağdelen, Hailey Joren and Alex Tamkin, Anthropic, 2026-10-26. https://www-cdn.anthropic.com/519c17a5d23a794e8b6d50a854048d0b61e0d73a.pdf

