
AI agent development:上線前要通過甚麼驗收
做 ai agent development 的企業,現在最常被追問的是憑甚麼簽收,模型是哪一代已經退到次要位置。Plurai 的答案來自自動駕駛:先用模擬環境把失敗情況跑出來,再用同一套評估證明模型真的可靠。這家公司 2026 年 11 月拿到 $13 million 種子輪融資,領投方是 Team8。
對香港中小企來說,這條路未必走得進去。模擬環境要建在公司自己的系統之上,成本不輕。但他們提出的問題值得整條供應鏈抄一次:上線前,你用甚麼樣本、甚麼評分規則、甚麼門檻,證明這個 agent 在你的生意裡真的能用。
為甚麼 demo 好、上線就出事
在華文市場問 ai agent development,同樣的問題換了一個問法:驗收做過沒有。
Plurai 共同創辦人 Ilan Kadar 接受 TechCrunch 訪問時把原因講得很直白:建 demo 很容易,做到可靠又划算就難。他和 Elad Levi 之前在 Nexar 做自動駕駛,Kadar 參與過與 Waymo 合作的端到端駕駛軟件模擬與評估。
他們把 agent 與自動駕駛模型歸為同一類系統:機率性、在不可預測的環境中運行。文章舉的例子很日常。被追問時,訂票 agent 可以無視差旅報銷規則;查單一數據庫時答得準,一旦要合併多個數據集就亂;客服對話一長,上下文塞得太滿,agent 就接不上。
這些問題在 demo 裡幾乎不會出現,因為 demo 通常用乾淨資料、短對話、單一系統。真上線才會遇到。
模擬企業環境:把失敗場景先跑一次
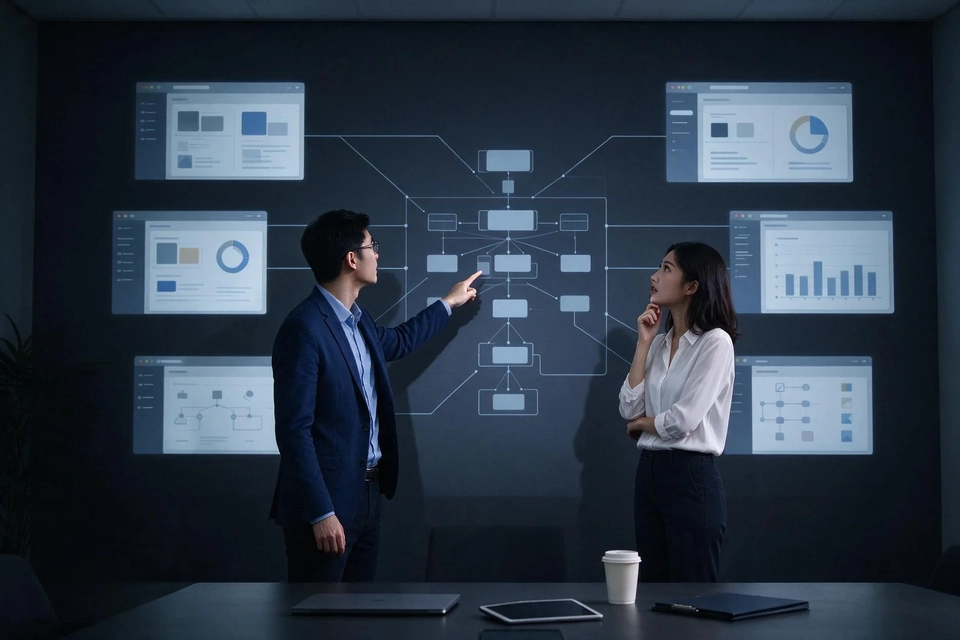
Plurai 的做法是替客戶建一個數碼分身,涵蓋知識庫和 agent 在生產環境會用到的工具,再把 agent 所有可能的路徑畫成圖,用這張圖準備評估,並針對邊界情況修正模型。平台可與 Claude Code、Codex、Copilot、Cursor 並行使用。
它真正的賣點,Kadar 說是拿收集到的資料去後訓練小的開源模型,按個別客戶的需要度身訂造。Plurai 官方 Blog 寫明,任何工程師可以從一段任務描述或幾個例子開始,在約 20 分鐘內後訓練一個開源模型。
同樣的思路也出現在第三方評測裡。AI 基建公司 EON 做了一個生成式企業環境基準,用來測 LLM agent 操作企業系統的能力。它的做法是:先隨機生成一間完整虛構公司的實體圖,再由產品模擬器提供 Salesforce、HubSpot、Zendesk、Slack、Stripe 等真實產品的介面,所有模擬器都是同一張實體圖的投影,所以跨系統的問題在結構上就有唯一答案。
EON 論文給出的數字有兩層。環境本身的真實度:這批生成公司的平均真實度分數由 61.8 提升至 97.0,被判定為合成資料的記錄比例由 55.2% 降至零。agent 的表現:九個模型回答同一批問題、每題重複三次,準確率估計介於 42.4% 至 76.8%。
TechCrunch 引述 EON 的另一組測試結果,表現最好的是 Claude Opus,準確率 76.8%。換句話說,即使是榜上第一,也有近四分之一任務做不對。這個數字對打算讓 agent 直接對客或直接改單的企業,是一條很實在的停一停的理由。
後訓練之後,成本與質素怎樣一起變
Plurai 與 NVIDIA、Nebius 合作的案例,把後訓練的效果量了出來。他們為一間全球企業後訓練了 NVIDIA Nemotron Lightning:訓練集由前沿教師模型標註,共三千餘段對話,用 LoRA 微調。
結果是,在真實生產對話上,這個後訓練模型在該項評分中得 88.8 分,高於 Claude Haiku;部署在 NVIDIA Blackwell 上以 NVFP4 服務,每 1,000 次呼叫 0.0078 美元。
這裡有個容易被誤讀的地方:高準確率來自「任務範圍夠窄」。提取、分類、路由這類高頻、領域固定的工作,才是後訓練的主場。跨部門、開放式的判斷,前沿模型仍然有它的位置。打算用一個 agent 包辦全公司流程的企業,用這些數字去談判會碰壁。
企業 ai 採購時,驗收條款要寫成甚麼樣
回到買方立場。這則新聞最實用的部分,是它把「評測」變成一個可以寫入合約的動作。以下是按 Plurai 和 EON 的做法整理出的驗收清單,香港企業可以直接拿去和供應商對。
<table>
<tr><th>驗收項目</th><th>要問的問題</th><th>供應商該交出的東西</th></tr>
<tr><td>樣本</td><td>用哪批任務測?來自真實工單,還是清理過的精選案例?</td><td>樣本清單與來源說明,含不可作答的問題</td></tr>
<tr><td>評分規則</td><td>誰判斷對錯?容許部分正確嗎?</td><td>評分定義,以及過去判斷不一致時怎麼處理</td></tr>
<tr><td>通過門檻</td><td>幾分算通過?低於門檻點算?</td><td>寫入合約的數字,與未達標的處理方式</td></tr>
<tr><td>工具與權限</td><td>測試是否真的經 CRM、ERP 接口取數?</td><td>測試環境的接口與權限清單</td></tr>
<tr><td>失敗處理</td><td>答錯時系統會怎樣?</td><td>例外測試記錄與轉人工的規則</td></tr>
</table>
EON 的做法提醒了一件事:測試環境的數據如果太乾淨,測出來的準確率沒有意義。他們專門注入受控的骯髒數值,也刻意放入「答案是資料不存在」的問題,避免 agent 靠猜過關。企業自己做試點時,也該保留這類難題。
至於 erp 系統 整合 這一段,接口通不通只是起步,關鍵在測試有沒有真的穿過那些接口。只用截圖或預錄對話驗收,等於沒有測過權限與資料映射。
哪些公司還未到要驗評測的階段
不是每間公司都需要建模擬環境。以下幾種情況,花錢做評測的順序應該排後面:
- 流程本身還未固定。連人工處理同一類工單都有五種做法,agent 沒有可學的基準。
- 數據源本身未清理。CRM 裡重複客戶佔比高、舊單未結案,先做資料整合比測 agent 划算。
- 使用量太低。每月幾十張單的場景,人工處理的總成本可能低於維護一套評測的成本。
- 只做曝光型用途。客服頁面上的問答機械人,答錯的代價遠低於改單、發貨或報價。
反過來,凡涉及金額、對外承諾或客戶資料的流程,驗收門檻就應該寫死在合約裡。
Topkee 的看法:驗收要寫在開發之前
Topkee 提供 AI Agent 開發服務,做法是把評測前移到合約階段:開發前先和客戶約定樣本、評分規則與通過門檻,再逐項核對資料口徑、輸出品質與工具參數。交付物包括驗收樣本與測試記錄,而不是只有一段演示。
這套交付框架有四項原則:結果能核對、動作有邊界、失敗有人接手、成果可以交接。落到流程是四個階段:評估與設計、開發與試點、驗收與上線、持續改進,正式驗收後提供一個月原範圍缺陷保修。
Topkee 的文件自己也給了一個誠實的例子:AI Agent 目錄裡列出的項目,包括 Skill、Bot Team 和 Plugin 幾類,但文件同時寫明目錄的項數不代表獨立成品數量,也不代表全部已完成業務驗收;其中部分依賴在當前身份下不可讀取,啟用前必須逐項核驗。沒有測試記錄的項目,就是未經測試。
還有一點值得抄:即使 agent 的運行記錄可以回答「做了甚麼、依據甚麼」,文件也註明那並非實際完成的獨立驗證。報表好看,與任務真的做成,是兩回事。
企業 ai 項目最容易出事的一環,是把「演示通過」當成「流程通過」。文件把上線前的檢查分成四類:目錄與依賴、業務服務(訂閱與權限)、運行環境(節點、模型、配額)、發布職責,並建議先建立現狀基線,再用真實任務小範圍試運行,驗收看完成率、用時、返工與人工介入。
想把 agent 接上 CRM、POS 等線下數據源,可以參考 TTO 的數據整合 做法;若流程牽涉電話跟進,Voice Agent 一類語音應用同樣要按這套門檻驗收。
下一步:從一份驗收樣本開始
如果你手上已有一個試運行中的 agent,最實際的下一步是先約定 ai agent development 的驗收樣本:抽出真實任務,補上評分規則和一條你願意簽字的門檻,讓供應商按這份樣本跑一次,功能開發可以先放着。跑完之後,你會清楚知道對面交的是成品,還是一個很會演示的原型。
需要一份可以直接放進採購文件的驗收框架,可以向 Topkee 索取 ai agent development 的交付清單,裡面有驗收樣本、測試記錄與缺陷保修的寫法。
常見問題
AI agent 要測多少個任務才算夠?
沒有通用數字,但重點在樣本的組成而非數量。EON 的基準用一批問題、每個模型重複三次,並做配對統計檢定。企業自測時,樣本應該覆蓋高頻任務、跨系統任務和「資料不存在」的任務各若干條,並記錄每條問題的預期答案。
供應商已經有自家 benchmark 成績,還要自己測嗎?
要。EON 的論文指出企業系統的真實數據屬於客戶且機密,公開基準只能覆蓋少數系統,而且真實度是宣稱而非量度。公開分數可以當參考,不能當成你的業務能否上線的證據。
後訓練的小模型真的可以取代前沿模型嗎?
在任務範圍窄、使用量高的場景,Plurai 的案例顯示可行:以三千餘段對話訓練出的模型,在真實生產對話上得分高於 Claude Haiku,成本也低得多。這類項目做 erp 系統 整合 時尤其要留意,訓練資料的來源必須是客戶自己系統裡的真實記錄。但這類結果依賴任務定義清楚、有代表性的訓練資料,範圍一放寬就不成立。
驗收之後誰負責維護?
合約裡應寫明保修期與改進機制。Topkee 的做法是正式驗收後提供一個月原範圍缺陷保修,之後按月依真實使用記錄做質量抽查與改進。
我們規模細,值得做這一套嗎?
如果 agent 只做問答展示,未必值得。但只要它會改單、報價或對外發送訊息,驗收就是風險管理,而不是額外開支。
Sources
- Tim Fernholz, "Plurai wants to help AI agents work better using the same approach that helped get self-driving cars to roads", TechCrunch, 2026-11-11. https://techcrunch.com/2026/11/11/plurai-wants-to-help-ai-agents-work-better-using-the-same-approach-that-helped-get-self-driving-cars-to-roads/
- "Plurai, Nebius and NVIDIA: Turn any open model into a frontier-beating model at 44x lower cost", Plurai, 2026-11-15 (accessed). https://www.plurai.ai/blog/vibe-post-training-turn-any-open-model-into-a-frontier-beating-model-at-44x-lower-cost
- Doron Porat, Assaf Natanzon et al., "The Era by Eon Benchmark: A Generated Enterprise Estate with Exact Ground Truth for Benchmarking LLM Agents", arXiv, 2026-09-09. https://arxiv.org/html/2609.09853v1

