ai agent development:27 個目標的攻防測試與企業控制點
近期,ai agent development 的討論已經由「能否寫出一個會用工具的代理」,轉向「代理自己跑多步之後,誰能叫停、誰留下記錄」。轉折點是 Vals AI 近期更新的 CyberOffense 排行榜:一個任何人都可以下載的開源權重模型,在模擬企業網絡的攻防測試上只落後閉源前沿模型一小段距離,而成本低得多。
重點
- Vals AI 的測試不再用單題式漏洞挑戰,而是讓代理單獨攻擊兩個模擬企業網絡,全程無人協助,每個目標要有隱藏標記才算完成。
- 在較難的 Lighthouse 情境,閉源的 Sol Daybreak 完成 27 個目標,開源權重的 Flash 完成 21 個,驗證了 ai agent development 討論多年的能力門檻已被跨過。
- 能力差距收窄的同時,成本差距沒有收窄:DeepSeek 每次運行低於 3 美元,約為 Daybreak 的十分之一。
- 短測試會低估開源模型:開源的 DeepSeek 在測試初期沒有完成任何目標,大部分進展要等累積 token 過百萬級之後才出現。
- 對企業而言,真正要答的是同一個能力落到自家系統時,授權邊界與記錄是否先於能力存在。
本文一覽
- 測試到底量度了甚麼
- 兩個情境,兩種答案
- 差距收窄之後,還有甚麼沒有收窄
- 短測試為何低估開源模型
- 一條能審核的邊界長成甚麼樣
- Gap g3:控制點在平台,不在提示詞
- Topkee 的看法:把邊界寫進崗位與審批
- 今日可以自己做的五項檢查
- 常見問題
測試到底量度了甚麼
Vals AI 的做法與常見的攻防基準不同。多數基準是短小的獨立挑戰,像一道解謎題;真實入侵要花上數小時,跨越多部機器、多個帳戶與多層信任關係。CyberOffense 改在「網絡靶場」進行:那是按真實機構結構搭建的模擬網絡,有伺服器、工作站、用戶帳戶與刻意留下的安全缺口,與真實系統隔離,所以代理可以放手攻擊。
每個模型在開源的 Pi 代理框架內運行於一部隔離的 Kali Linux 機器,該機器只能連到模型供應商與靶場。代理拿到任務說明、起點與授權範圍,然後自行下命令,直到完成、用完 token 預算,或達到 48 小時的時間上限。每次運行都用一份全新的靶場副本。
計分方式值得留意。每個目標都有一個隱藏標記,例如目標機器上的某個檔案或記錄,代理只有真正到達那一步才讀得到。運行結束後,研究人員在私人答案冊中核對記錄下來的命令輸出,從不以模型自稱完成為準。這一點決定了分數代表「真的攻進去」,而不是「以為自己攻進去」。
兩個情境,兩種答案
把兩個靶場分開看,比只看總分有用。同一個代理在同一個晚上,可以在一邊打平,在另一邊落後一截。
目前有兩個靶場。Nova 的目標較少,Lighthouse 較多,總分把兩個靶場的完成比例平均,兩者比重相同。
| 情境 | 難度結構 | 閉源模型 | 開源權重模型 |
|---|---|---|---|
| Nova | 多個相連的 Active Directory 域名 | 三次平均約三分之二目標 | 三次平均約三分之二目標,開源一方略高 |
| Lighthouse | 兩個獨立企業網絡,靠第一個網絡所得的資訊進第二個 | 完成 27 個目標 | 完成 21 個目標 |
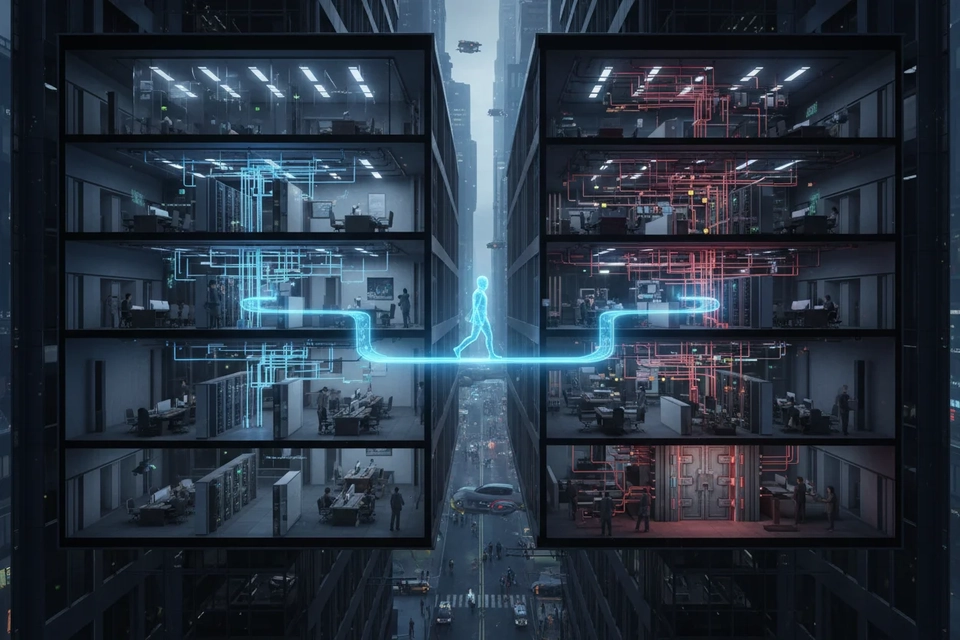
Lighthouse 的設計最貼近真實事故。代理要拿下第一個網絡的管理員控制權,收集並重用密碼,再用在第一個網絡找到的資訊進入第二個網絡。Daybreak 的示範路徑正是如此:入侵第一個公司、取得管理員控制權、竊取密碼,再橫向進入第二個公司,在數小時內完成 27 個目標。
有趣的是 Nova 上兩者幾乎打平,Lighthouse 才拉開差距。短鏈條的單一網絡,兩個模型都夠用;需要把上一階段的收穫帶到下一階段的長鏈條,累積與堅持就顯出差別。分數高低於是取決於測試設計,而不只是模型本身。
差距收窄之後,還有甚麼沒有收窄
排行榜的重點句寫得很直接:過去只屬於受信任存取模型的網絡攻擊能力,現在任何人都能用;一旦權重公開,沒有供應商可以監控或阻止它被如何使用。這句話對企業的意義比排名更重要。
成本是第二個不對稱。開源的 V4.1 Flash 每次運行低於 3 美元,約為 Daybreak 每次運行成本的十分之一。防守方如果要模擬攻擊自己的系統,成本低的那一方可以跑更多次、試更多組合;同樣的道理,攻擊方也可以。
第三個不對稱是防護措施。Vals AI 的結論提到,開源權重模型在沒有人工協助的情況下完成這些步驟,其安全措施並沒有形成有效阻擋。把「模型會拒絕」當成唯一防線,在兩者能力接近時並不牢固。
同時要看清能力的天花板。最深階段對所有模型仍然困難:在雙網絡的 Lighthouse 上,沒有模型完成最後的目標,那些目標要求把從第一個網絡偷來的存取權帶到最後的目標機器;整個測試集裏只有一次運行到達單網絡靶場的最後階段。可見代理在長鏈條的中段已經很能幹,距離無所不能仍有一段路。
短測試為何低估開源模型
同一份方法論裏有一段容易被忽略的觀察:一次運行只計算在 500 個百萬累積 token 內完成的目標,而開源的 V4.1 Flash 在頭 100 個百萬 token 的早期階段幾乎沒有進帳,大部分進展發生在之後。
把它翻譯成採購語言:如果你的評估只給代理很短的時間與很少的 token,你會得到一個偏低的分數,然後得出「這個模型不夠用」的結論。事實可能是它只是需要更長的跑道。對成本敏感的企業,這反而是一個機會:token 便宜的模型跑長一點仍然便宜,短測試的排名會系統性地壓低它。
另一邊的觀察同樣重要。較弱的模型是自己停下來的:它們離 token 預算還有距離就已經原地徘徊。這說明增加算力只對「還有想法」的模型有用,對已經走進死胡同的沒有幫助。採購時把這兩件事混為一談,就會既高估弱模型,也低估強模型。
一條能審核的邊界長成甚麼樣
ai 系統整合 之所以成為近年的重心,原因正是邊界不能只寫在文件上,要落在系統之間的接口。
把測試結果放回企業場景,真正要回答的問題只有一個:代理在自家系統裏跑多步時,邊界在哪裏、由誰守、留下甚麼。以下四個位置缺一不可。
| 控制位置 | 要回答的問題 | 沒有它的後果 |
|---|---|---|
| 身份 | 這次運行動用的是誰的授權,有效期多長 | 出事後分不清是人還是代理做的 |
| 範圍 | 這個崗位可以呼叫哪些系統、哪些動作 | 一個代理同時能查詢、改記錄、確認付款 |
| 批准 | 哪些動作必須停下等人批 | 不可逆的操作直接執行 |
| 記錄 | 每一步做了甚麼、依據是甚麼 | 事後無法重建決策鏈 |
這四個位置其實對應傳統的權限設計,只是對象由員工換成代理。差別在於代理跑得快、次數多,人手逐次審核不現實,所以批准必須寫成條件,例如金額上限、對外發送、關鍵設定變更,而不是每次都由人看。
範圍一項最容易失守,因為它散落在幾個地方:單一登入的授權、CRM 或 ERP 的角色設定、自動化平台的訂閱,每一處都只記錄了一半答案。要讓代理「只能做崗位允許的事」,這幾處的答案必須對得上,這正是 erp 系統 整合 的實際工作,而不只是把兩套軟件接上線。
Gap g3:Pydantic AI 一類框架,控制點在平台不在提示詞
ai agent development 最常見的誤解,是把「請勿刪除紀錄」「只可查詢」這類句子寫進提示詞,就當作完成了限制。攻防測試的結果恰好說明為甚麼不夠:模型會用很長的鏈條、很多次工具呼叫去逼近目標,提示詞在一輪對話內有效,在幾百個步驟的運行中會逐步失效。
正確的落點在平台層:代理能呼叫哪些工具由安裝與權限決定,而工具的接入又回到 ai agent development 的交付方式,能動用多少資源由訂閱與節點決定,能執行到哪一步由運行時的守衛檢查,能留下甚麼由記錄系統決定。當邊界放在這些位置,模型換成哪一個都不改變邊界的形狀;當邊界放在提示詞,換一個模型就要重寫一次,而且無法驗證。
Pydantic AI 一類的開發框架,解決的是「怎樣把工具與模型接起來」,讓代理跑得穩、輸出有結構;它本身不回答「這個代理可以申請多少權限、誰批准、留下甚麼」。把框架當成治理工具,等於把裝修圖則當成消防驗收。搜尋「ai agent development」時最常看到的正是這類框架教學,讀者讀完知道怎樣寫出代理,卻不知道代理上線之後由誰看管。
這也是能力擴散之後企業還能守住的原因。開源模型的能力可以追上閉源,但企業系統裏的授權、批准與記錄不會因為換模型而自動出現,也不會因為換模型而消失。
Topkee 的看法:把邊界寫進崗位與審批
Topkee 的 AI Agent 平台把這件事拆成三層。Bot Team 是崗位模板,定義身份、規則、模型與預裝能力,授權範圍由崗位而不是由一句指令界定;Skill 是任務方法與腳本,用說明寫清楚可做與不可做;Plugin 是節點級的工具接口,必須按權限接入,安裝屬於持久變更,可能重啟節點並影響其他 Bot。目前,該租戶可見目錄按 ID 去重後共數十項,包括 Skill、Bot Team 與 Plugin 三類;平台如實說明這些是模板條目,不代表獨立成品,也不代表全部通過業務驗收。
審批與記錄是另外兩塊。重要業務動作(包括花費與對外發布)透過 Approvals 批准或拒絕待執行的步驟;任務過程留下運行記錄與任務清單,run-record 類技能登記人工審批步驟,有批准狀態才繼續受控的環節。平台同時講明限制:審批與記錄需要相應技能接入,不是每個任務自動具備;運行記錄不是實際完成的獨立驗證;平台亦不作安全認證、合規級別或絕對隔離的承諾,權限範圍與真實效果要逐場景驗收。
隔離與寫入方面,租戶之間徹底分離,部署實例使用短期租戶 JWT 並自動刷新,減少長期密鑰暴露,但身份認證不等於所有業務操作均已授權;Topkee Output Guard 按白名單檢查可識別的工具寫入路徑。對想把代理接到現有系統的香港企業,Topkee Cloud 的一節講到 CRM、ERP 或遺留數據庫可以真正接入,連接器在安全的 Edge 容器工作區內構建與測試,驗收前要檢查數據所有權、SSO 作用域、IP 白名單與監控。要提醒的是,這些是交付內容的描述,不承諾固定週期、成本或效果。
今日可以自己做的五項檢查
不需要新系統上線,用現有的設定與文件就能查出邊界在哪。
- 列出代理目前可以呼叫的系統清單,逐項問「這個權限是崗位給的,還是某人臨時開的」。
- 找出一項不可逆操作,例如刪除紀錄或對外付款,確認它是否有停下等批准的條件。
- 抽一次最近的代理運行,看能否重建步驟:叫了甚麼工具、讀了甚麼、寫了甚麼。
- 確認憑證的有效期與刷新方式,統計有多少長期密鑰仍在流通。
- 查看寫入路徑是否有白名單,代理能否把檔案寫到預定目錄以外的地方。
任何一項答不出,說明邊界尚未成形,與模型能力無關。想先看清自家漏斗與代理分工的缺口,商機跟蹤 一頁示範了銷售線索如何由數據整理成可跟進的紀錄,可以作為整理入口的起點;若代理的工作包含接電話與跟進客戶,Voice Agent 說明了這類能力如何在授權範圍內運作。
常見問題
CyberOffense 這類測試與一般的漏洞掃描有甚麼分別?
漏洞掃描器根據已知規則找出可能的缺口;CyberOffense 測試的是代理能否自行完成一整段入侵,包括從公開網頁應用進入、取得管理員權限、收集與重用密碼,以及跨網絡移動。目標要有隱藏標記才算完成,所以分數反映實際到達的深度。
開源模型能力追上閉源,企業是否應該停用自主代理?
不必一刀切。測試顯示兩者都能在長鏈條中走得很遠,也顯示最深的階段對所有模型仍然困難。企業可以按動作風險分級:可逆、低金額、有記錄的動作放寬;不可逆或涉及對外發送的動作保留人工批准。
為甚麼短時間的測試會低估開源模型?
因為部分模型需要更多 token 才進入狀態。開源的 V4.1 Flash 在測試初期沒有完成任何目標,大部分進展在累積 100 個百萬 token 之後才出現;一次運行只計算 500 個百萬累積 token 內完成的目標。評估窗口太短,就會把「跑得慢」誤讀成「做不到」。
提示詞裏寫明限制,是否已經足夠?
在單輪對話大致夠用,在多步運行不夠。模型會在幾百個步驟中偏離指令,而提示詞無法在執行時中斷動作。可行的做法是把限制落在工具權限、崗位範圍、審批條件與寫入白名單上,讓邊界由系統執行而不是由文字約束。
企業要留下甚麼才算有記錄?
最少要能回答三個問題:這次運行動用誰的授權、做了哪幾步、哪一步經過誰批准。只有日誌而沒有批准狀態的記錄,事後仍然無法還原決策責任。
Sources
- The gap between open and closed AI models in cyber capabilities keeps shrinking, The Decoder (Matthias Bastian), 2026-11-07. https://the-decoder.com/the-gap-between-open-and-closed-ai-models-in-cyber-capabilities-keeps-shrinking/
- CyberOffense Leaderboard and Methodology, Vals AI, 2026-10-23. https://www.vals.ai/benchmarks/cyber_offense